Accelerarea generării de imagini cu FLUX 3 Image Klein pe GPU-urile Blackwell NVIDIA
Pe un GPU NVIDIA Blackwell, NVFP4 a oferit Atunci când se implementă modele de difuzare în instrumentele de design, editorii de imagini și fluxurile de lucru de producție vizuală, dezvoltatorii…
- autor
- Radu Ionescu-Vlad
- publicat
- secțiune
- tehnologie/
- citire
- 3 min
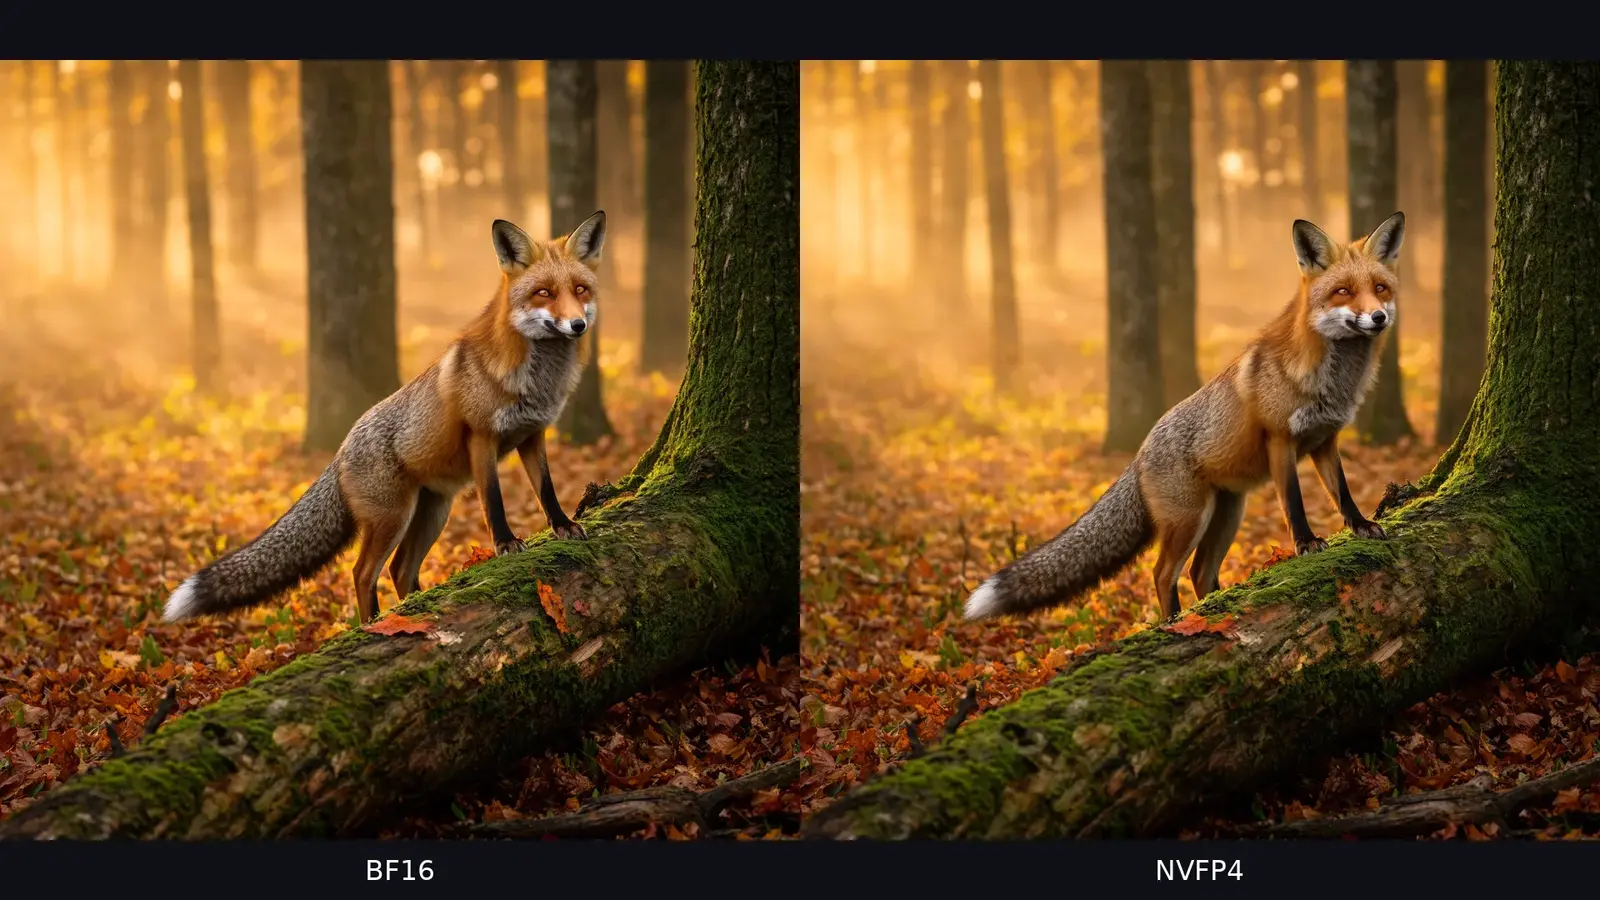
Pe un GPU NVIDIA Blackwell, NVFP4 a oferit
Atunci când se implementă modele de difuzare în instrumentele de design, editorii de imagini și fluxurile de lucru de producție vizuală, dezvoltatorii trebuie să țină cont de latența de inferență. Generarea unei imagini necesită multiple treceri secvențiale printr-un model cu miliarde de parametri, iar rezoluțiile mai mari cresc costurile de atenție.
FLUX 3 Image Klein este un model de editare și generare de imagini de la Black Forest Labs (BFL) instruit pe NVIDIA GB200 NVL72 și optimizat pentru GPU-urile NVIDIA.
Acesta oferă puncte de control de bază și distilate pentru diferite cerințe de latență și fidelitate.
Acest tutorial arată cum să configurezi FLUX 3 Image Klein în NVIDIA TensorRT LLM VisualGen pentru a profita de kernel-uri fusionate, paralelism multi-GPU, suport FP8/NVFP4, caching și optimizări de atenție.
Compară latența și modificările în rezultatele generate în cadrul optimizărilor.
În testele raportate 2048 × 2048 pe un singur GPU NVIDIA B200, optimizările combinate au oferit până la 3,46x mai rapidă generare text-to-image (T2I) și 4,45x mai rapidă generare image-to-image (I2I) pentru FLUX 3 Image Klein Base în comparație cu inferența BF16 necompilată. Tutorialele includ instrucțiuni de implementare și configurări YAML pentru aplicarea acestor optimizări la sarcinile de lucru.
FLUX 3 Image Klein combină Qwen3-VL-4B-Instruct pentru condiționarea textului, un transformator de difuzie (DiT) pentru a rafina latențele imaginii și un autoencoder pentru a decodifica latențele în imagini și a codifica intrările de referință I2I.
Klein prelucrează textul, imaginea țintă zgomotoasă și fluxurile opționale de referință înainte de a le combina prin atenție comună. TensorRT LLM VisualGen, un runtime dedicat în cadrul TensorRT LLM, a susținut variantele BF16, FP8 și NVFP4 la lansare.
Pe un GPU NVIDIA Blackwell, NVFP4 a oferit până la 1.62x mai rapid T2I și 1.58x mai rapid I2I generație decât BF16.
Figura 2 compară latența generării, în timp ce figura 1 compară rezultatul de exemplu. Secțiunile următoare folosesc NVFP4 ca punct de plecare pentru optimizarea ulterioară. Figura 1 compară rezultatele la 2048×2048.
Adaptate pentru formele de tensor FLUX 3 și activate de par default, combină GEMM-uri optimizate cu epilogi fuși
Răspunsul T2I rezumat descrie o bucătărie moartă; Răspunsul I2I rezumat solicită modificări la o scenă spațială, inclusiv un gigant de gaze roșii, un dragon argint și o placă gravată.
Figura unu. Cu NVFP4 ca punct de plecare, optimizările VisualGen s-au întors la denoizare, care domină timpul general de generare pe B200. Accelerarea FLUX 3 s DiT este, prin urmare, în centrul următoarelor secțiuni.
Tabelul 1 arată latența pipeline la 2048 × 2048 pe un singur GPU NVIDIA B200 folosind NVFP4, atenția VANILLA și torch. compile. Rezultatele sunt în medie peste 10 cereri după două cereri de încălzire.
Baza folosește 50 de etape de denotare cu o scară de orientare fără clasificator (CFG) de 3,5; Klein distilatul folosește 16 etape fără CFG. TensorRT LLM VisualGen accelerează inferența NVFP4 DiT cu kernel-uri optimizate de multiplicare generală a matriței (GEMM) și fuziune epilogă, atenție de mică precizie și scură, caching și executare multi-GPU.
Cu excepția cazului în care se menționează altfel, următoarele benchmarks utilizează torch. compile și seed 0. Baza folosește 50 de pași de denotare și un pași de denotare. VisualGen susține punctele de control pre-cuantificate NVFP4 DiT BFL pentru FLUX 3 Image Klein și FLUX 3 Image Klein Base.
Pentru a utiliza aceste puncte de verificare, setați varianta la nvfp4 în pipeline_config: pipeline_config: variant: nvfp4 TensorRT LLM VisualGen utilizează kernele GEMM PrimsTS FP8/NVFP4 ale FlashInfer, construite cu CUTLASS Primitives și Schedularea de sarcini pentru a accelera inferența cuantizată.
Adaptate pentru formele de tensor FLUX 3 și activate de par default, combină GEMM-uri optimizate cu epilogi fuși, inclusiv GEMM cu SwiGLU și proiecții de cerere, cheie și valoare (QKV) cu normalizare de cerere / cheie și încorporări de poziție rotativă (RoPE). Vezi FlashInfer PR #5758 pentru detalii. La lansare, kernel-urile NVFP4 PrimsTS fixate au oferit 1.02-1.10x mai rapidă generație T2I pe B200 decât implementarea GEMM NVFP4 a TensorRT LLM. Atenția este un deget de sticlă major în generarea de imagini cu rezoluție ridicată.
În testele NVFP4 T2I de 2048×2048 raportate pe B200, atenția VANILLA BF16 a reprezentat aproximativ 60% din timpul de corespondență al DiT GPU atât pentru Base, cât și pentru Klein distilat.
VisualGen sprijină două abordări pentru reducerea acestui cost: atenția cuantizată cu cuDNN FP8 sau VC-Attention FP8, și atenția scură cu Sol-Attention. VC-Attention FP8 este o variantă a metodei descrise în lucrarea VC-Attention.
replici (0)
$ cat replici.log — fișier gol. Fii primul care răspunde.